七分学弟
做雅思辅导时我发现,学生看过 AI 批改,下一次还是犯同样的错。我先做了 IELTS Writer,把批改和追问、错题本连起来。今年 11 月轮到我自己考雅思,写作是短板,我把它重做成七分学弟:每次只学一小步,批改给出能核对的依据,再用官方考官打过分的作文检验它准不准。
项目背景 / Problem
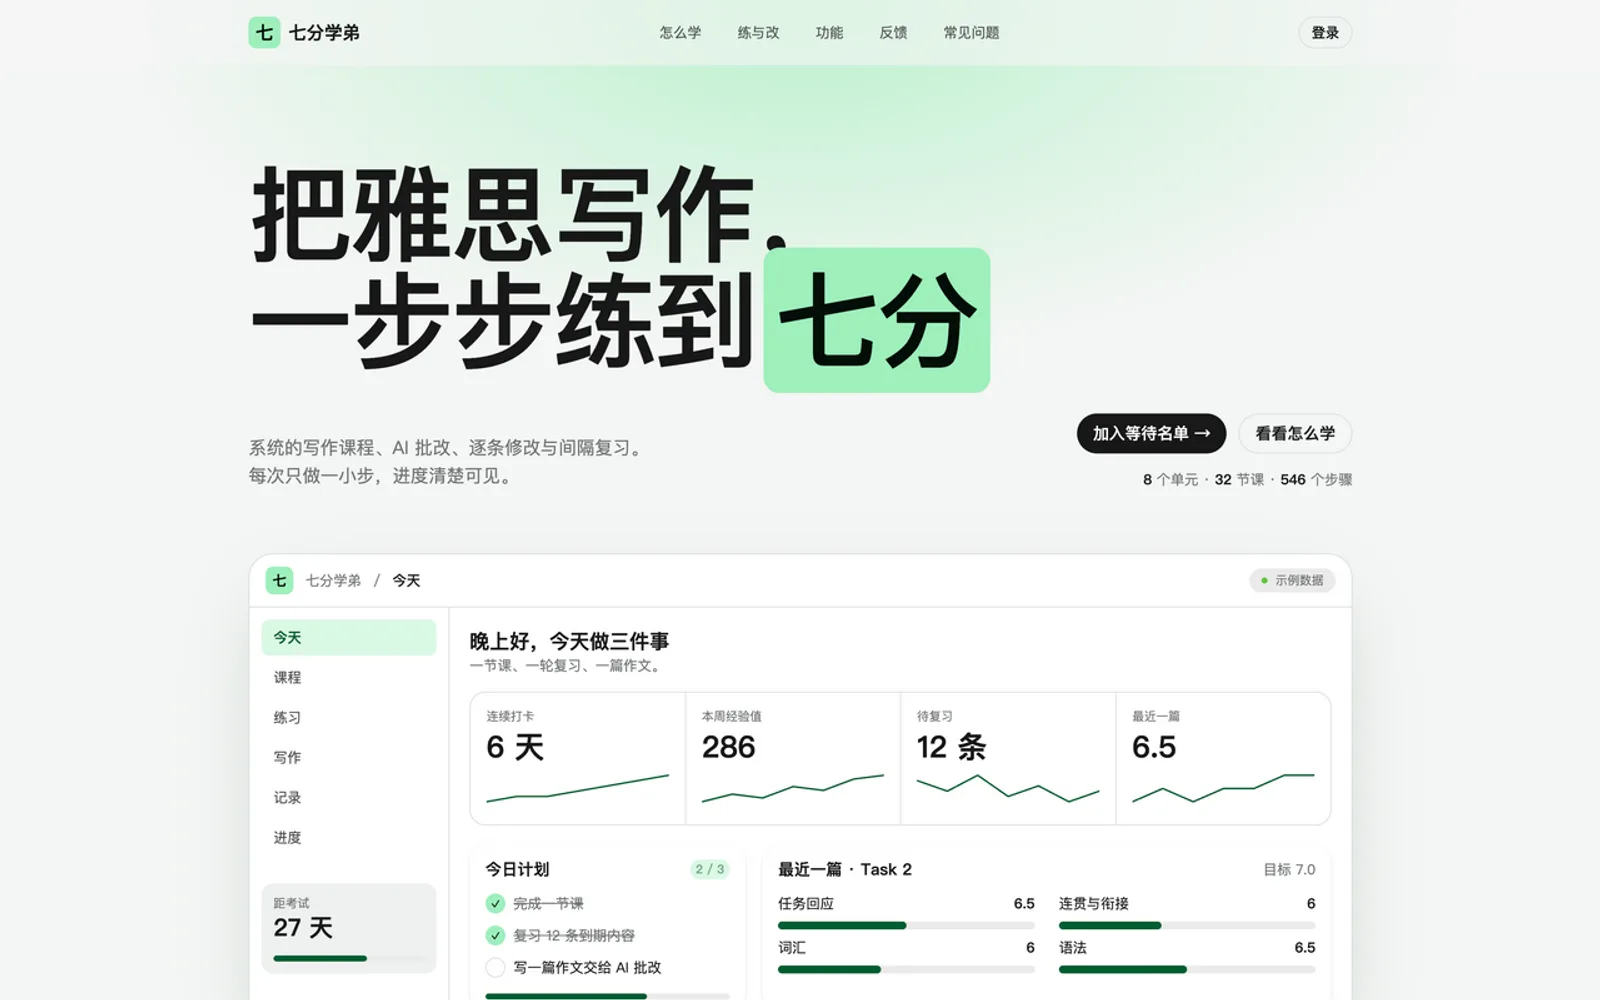
一款雅思写作学习应用:互动课程、AI 批改、逐条修改复查和间隔复习。分数由代码按规则计算,模型只负责找证据和写反馈。
我的角色:AI Native:产品设计、评分规则与评测、实现组织与部署
看过批改,下次还是错
做雅思辅导时,我常看到同一个场景:学生把作文丢给 AI,拿回一个分数和一段“写得不错,但可以更好”的评语,扫一眼就关掉了。下一篇,同样的问题又出现。
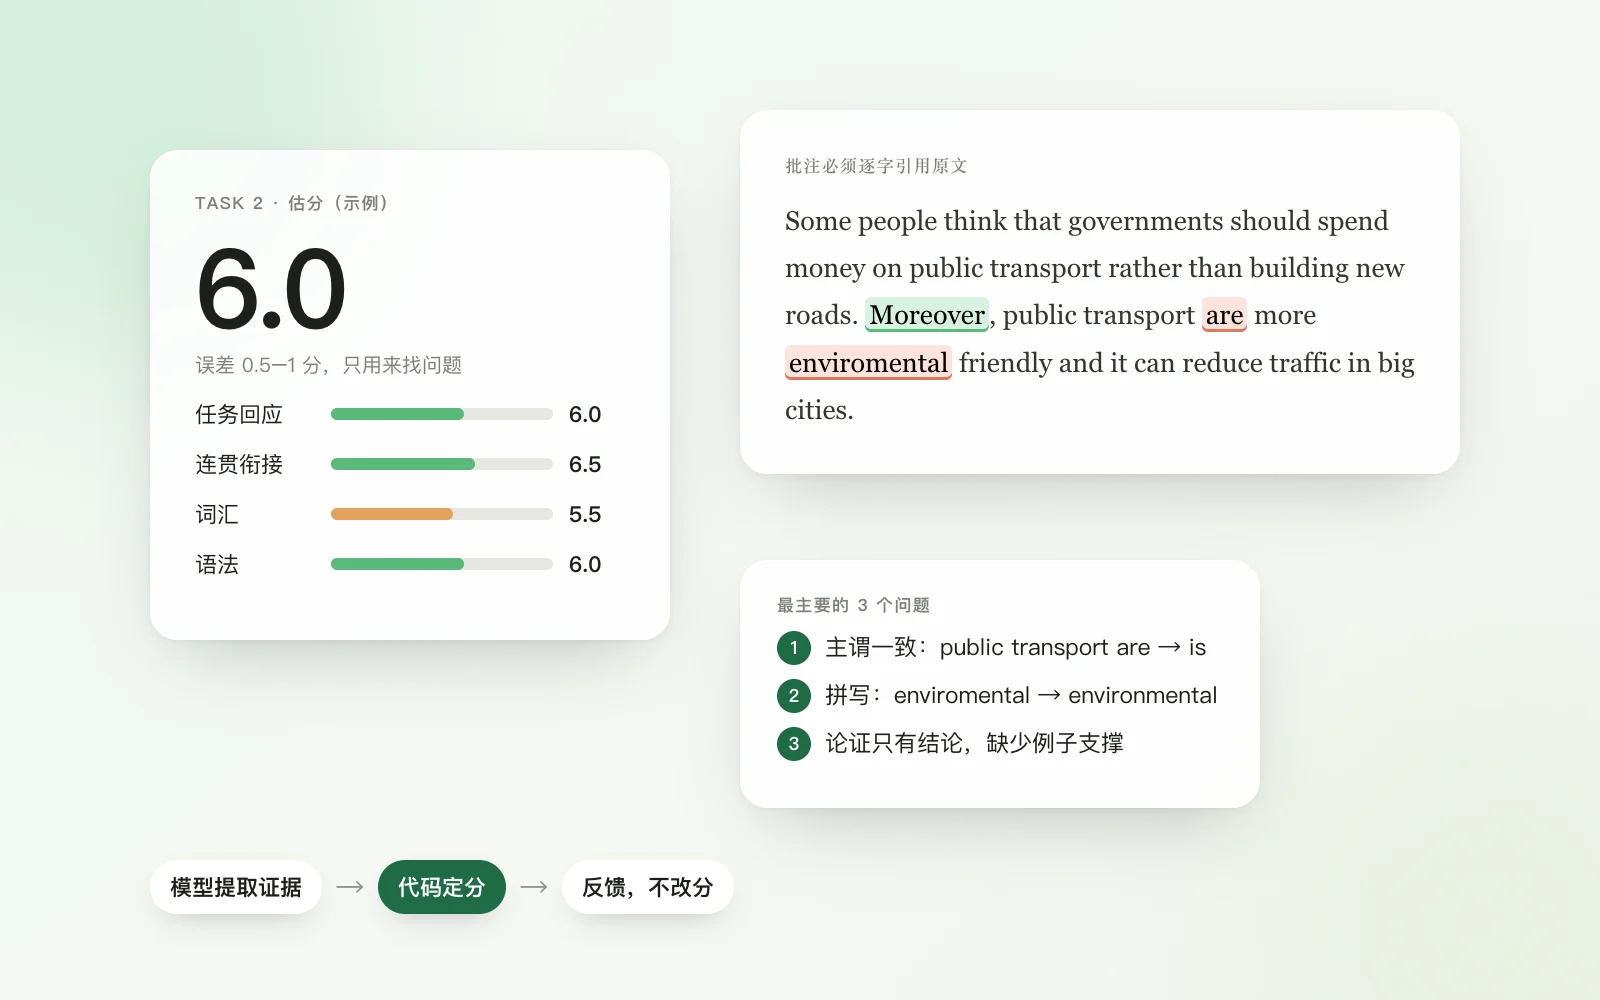
问题不在于反馈不够多,而在于反馈没有接到下一次练习里。所以 2026 年 5 月我做了 IELTS Writer:按雅思四项评分组织反馈,可以针对报告继续追问,把要复习的问题存进错题本。它后来也叫过 EssayLoop。
轮到我自己考
今年 11 月我要考雅思,写作是我的短板。资料买了不少,看完的感觉是知道了很多,可写出来的作文到底好不好,我自己判断不了。
10 月 9 日,我和 Claude Code 用一天把它重做了一遍。这次我想要的不是刷题工具,而是一个能带着我练的东西:每节课分“概念、讲解、案例、测验”四小步,每步只占一屏,想停就停,回来接着做;答错的题进入复习队列,过几天再回来练。
名字也是那天定的。我觉得两个字的名字有点装,想要一个像身边人的名字,最后选了“七分学弟”。七分是我的目标分,不是我已经考到的分数;“学弟”的意思是,它像一个陪你一起练的人。
一篇普通作文,AI 给了 8 分
上线当晚,我拿一篇很普通的作文试批改:结构清楚,连接词一个不少,但内容是模板化的。按评分标准大概 6 到 7 分,AI 给了 8.0。
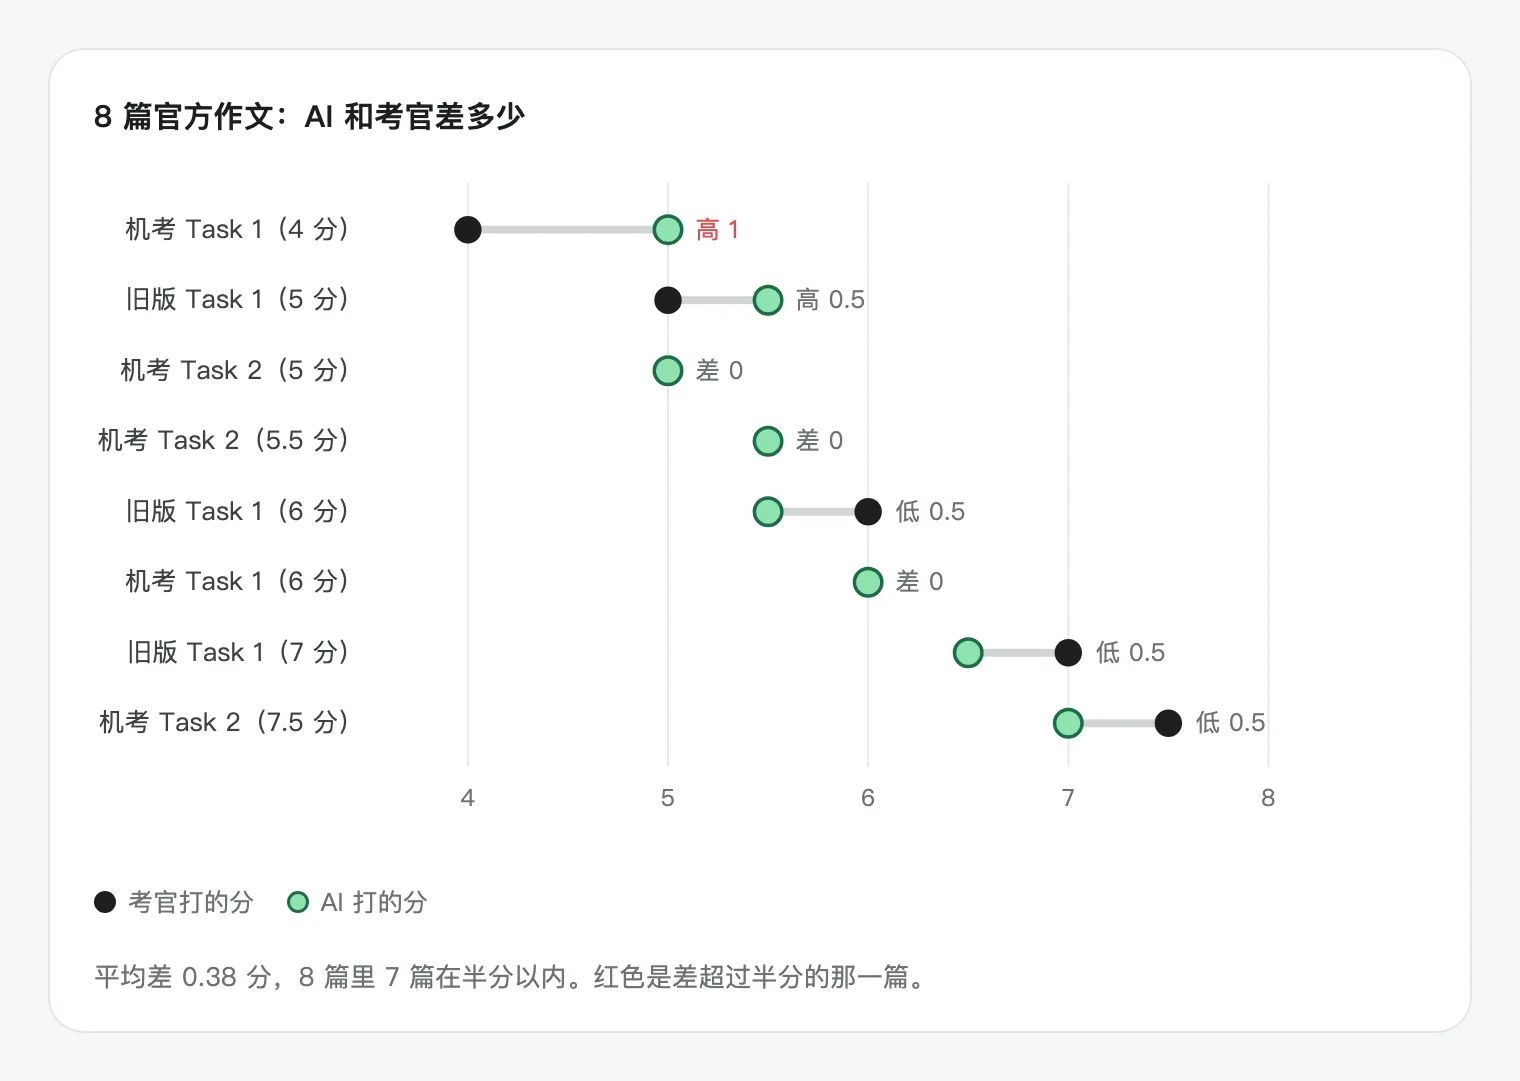
一个偏高的批改员,比没有批改员更危险,因为它会让你放心。我没有直接改提示词,而是先找了一把尺子:雅思官方公布的、带考官分数的真实作文。第一次对比,平均差 0.58 分。
评分本来就分成三步:模型只提取看得到的证据,不打分;代码按规则把证据换算成分数;模型再写中文反馈,不许改分。这样分数可以复现,哪里不对也能追到是哪条证据、哪条规则。
模型会自动“脑补”错别字
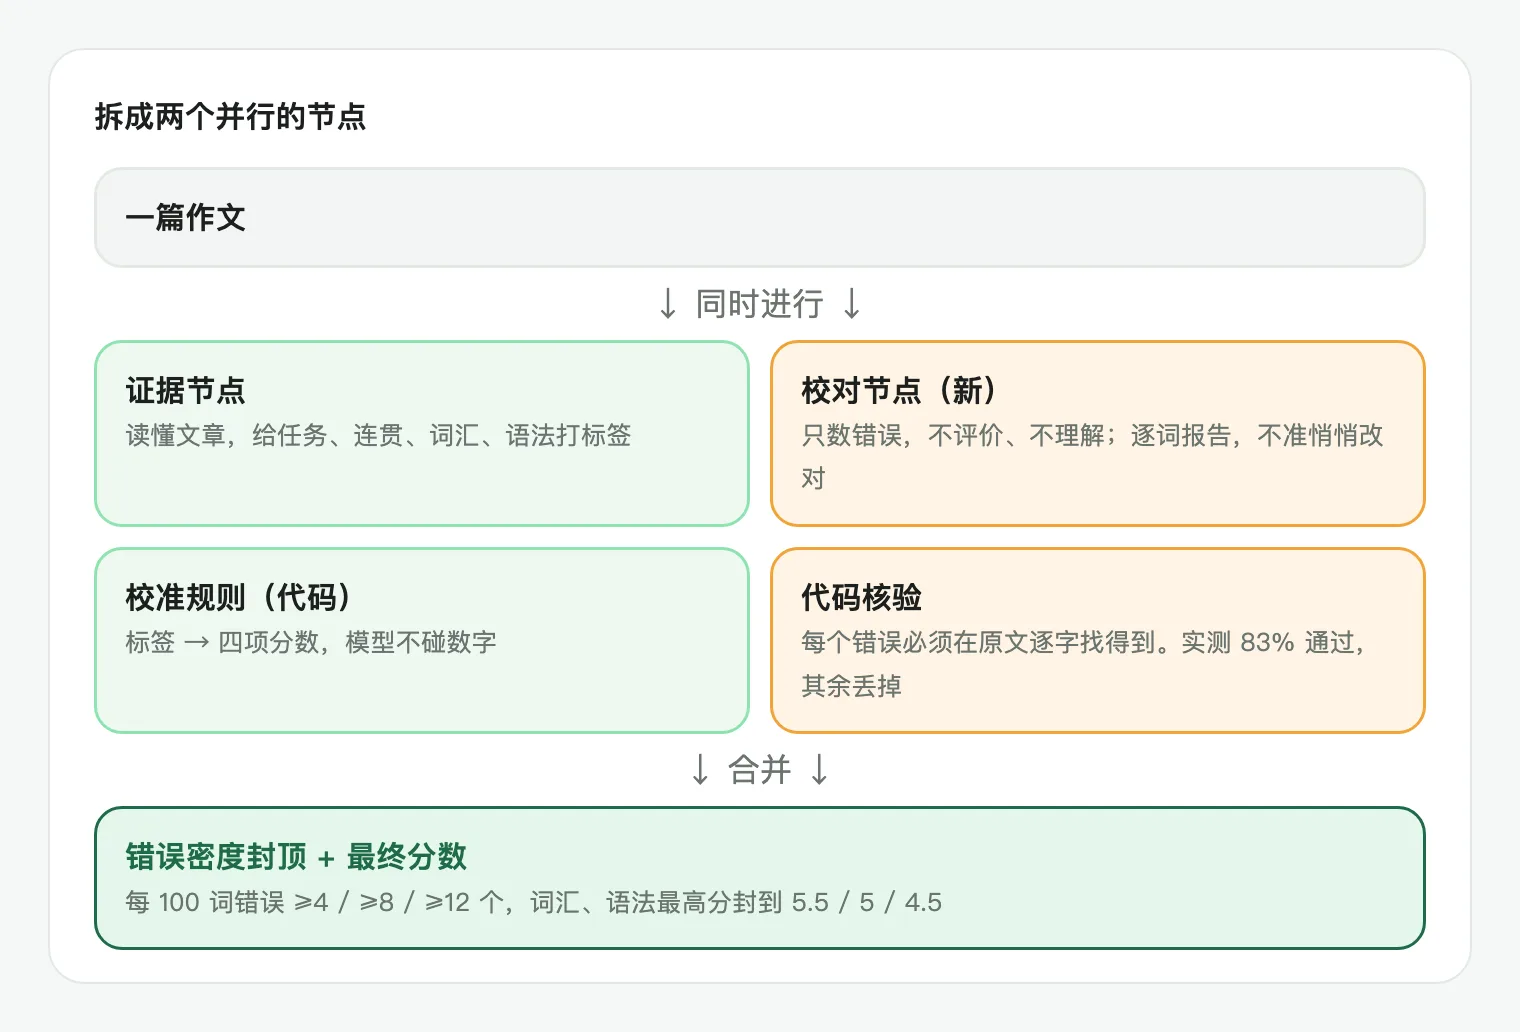
我又拿公开作文数据集看趋势,发现 AI 几乎给所有作文都打 6 到 7 分,对错误很不敏感。我的猜想是:模型读到 nowdays、peoples,会顺着上下文自动理解成 nowadays、people,读的时候就“改对了”,所以没看见错误。
解法是把校对拆成单独一步:只逐词报错,不评价。代码再逐条核对报出的错误是否真的逐字出现在原文里,83% 能核验,其余当作幻觉丢掉。最后按每 100 词的错误密度给分数封顶。
一篇我故意写满错误的短文,现在拿到 5.0 分;那篇干净的模板作文仍是 7.0。官方作文扩到 8 篇后,平均差 0.38 分,7 篇在半分以内。
我没有把话说满
官方带分数的作文只有 8 篇,调参和验证用的是同一批,数字偏乐观;外部数据集上的相关性提升也有限。所以界面上写的是:AI 估分有 0.5 到 1 分误差,分数用来找问题,不当作成绩。
现在落地页公开,应用需要登录,还在等待名单阶段。考完试之后,我会再决定它往哪里走。
结果与范围 / Now
8 个单元、32 节互动课;AI 批改按四项评分并指出最主要的 3 个问题,修改后逐条复查
评分拆成“模型提取证据 → 代码按规则算分 → 模型写反馈”,同一组证据永远得到同样的分数
8 篇官方考官评分作文上,平均误差从 0.58 降到 0.38,7 篇差在半分以内;样本少,仍在继续验证